GPT-5.6 Sol 深度测评:多智能体协同能否改写复杂工程工作流?
围绕 GPT-5.6 Sol 的多智能体协同、复杂工程任务与真实生产力场景,拆解其能力边界、适用场景与选型建议。
写在前面
2026 年的大模型竞争,已经从“谁更会聊天”转向“谁更能把复杂任务做完”。OpenAI 的 GPT-5.6 Sol 正是这一趋势下的旗舰档位代表:它强调多智能体协同、系统架构设计与长程工程执行,而不是单次问答的花活。
本文从产品定位、核心能力、适用场景与风险边界四个方向,给出一份面向开发者与产品团队的实战解读。
GPT-5.6 Sol 的定位:不是更快,而是更能“收尾”
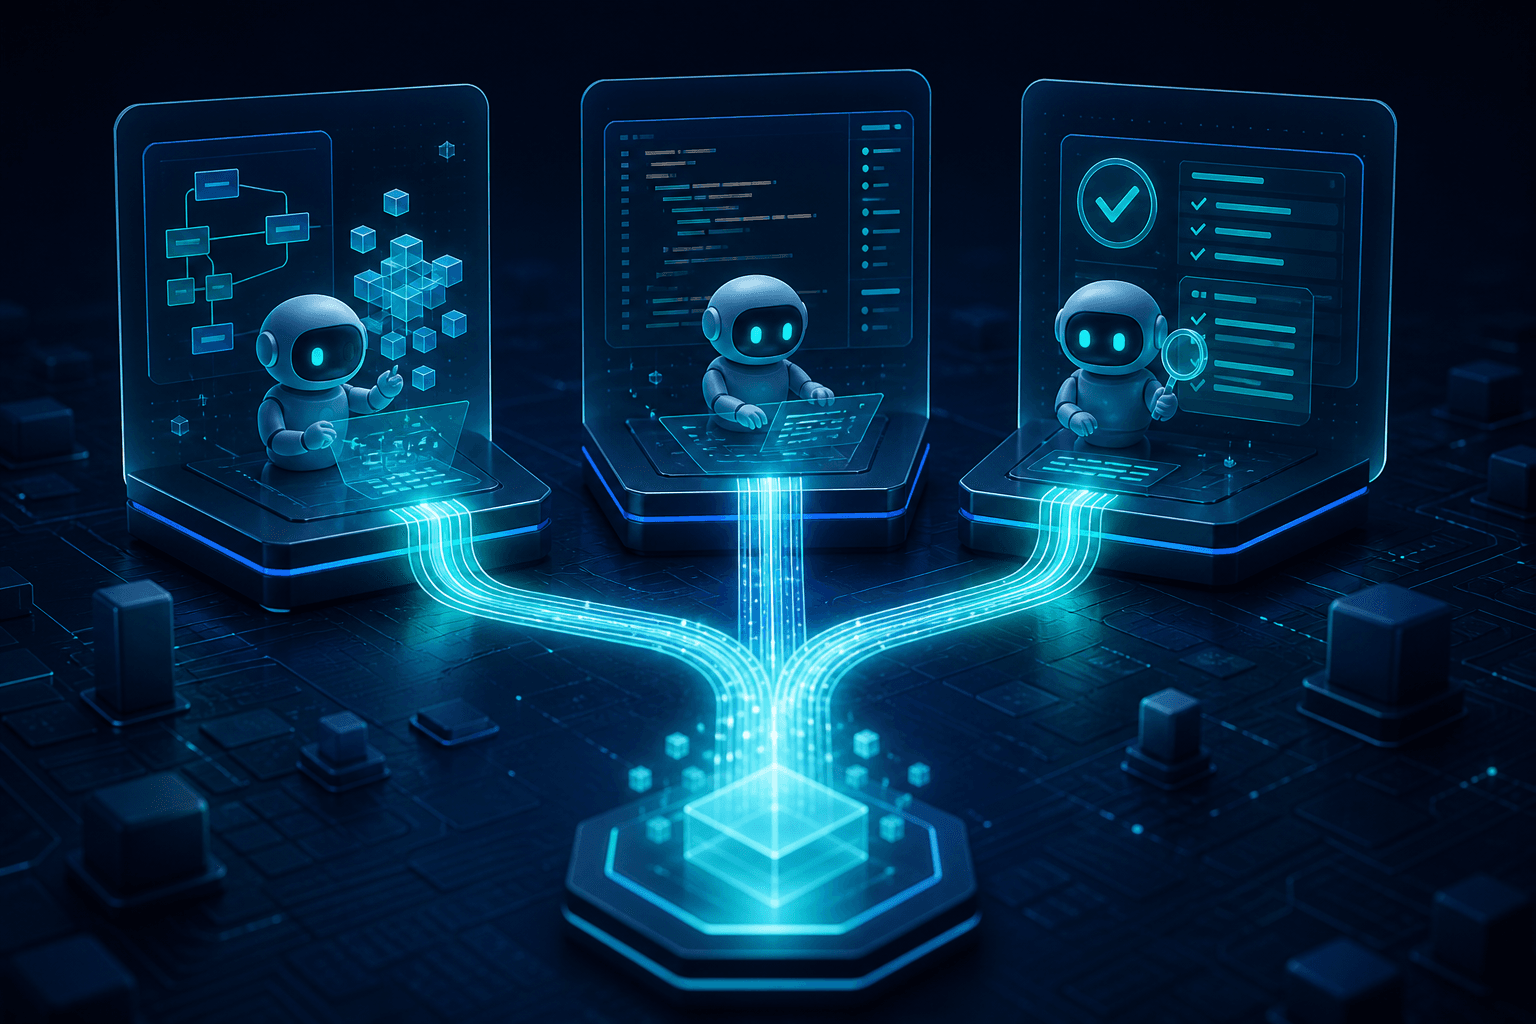
和偏即时响应的轻量模型不同,Sol 更像“工程总控台”:
- 任务拆解:把模糊需求转成可执行子任务
- 角色分工:研究、编码、验证、汇总可并行推进
- 结果收敛:强调最终交付物的完整性与可检查性
如果你的日常是写短文案、做单轮翻译,Sol 可能过重;但如果你要做跨仓库迁移、多服务联动改造、复杂系统设计,它的价值才会显现。
核心能力拆解
1. 多智能体协同
Sol 的卖点并不是“一个更强的脑”,而是“一组可协作的执行单元”。在复杂工程中,这意味着:
- 一个代理负责梳理约束与现状
- 一个代理负责实现关键路径
- 一个代理负责回归验证与风险提示
最终由上层策略合并结果。这种结构更接近真实团队协作,而不是单线程对话。
2. 复杂工程任务表现
在系统架构设计、跨模块重构、脚本自动化等高摩擦任务中,Sol 的优势通常体现在:
- 对隐含约束更敏感
- 更愿意给出可落地的分步方案
- 对“做到什么程度算完成”有更清晰的停损线
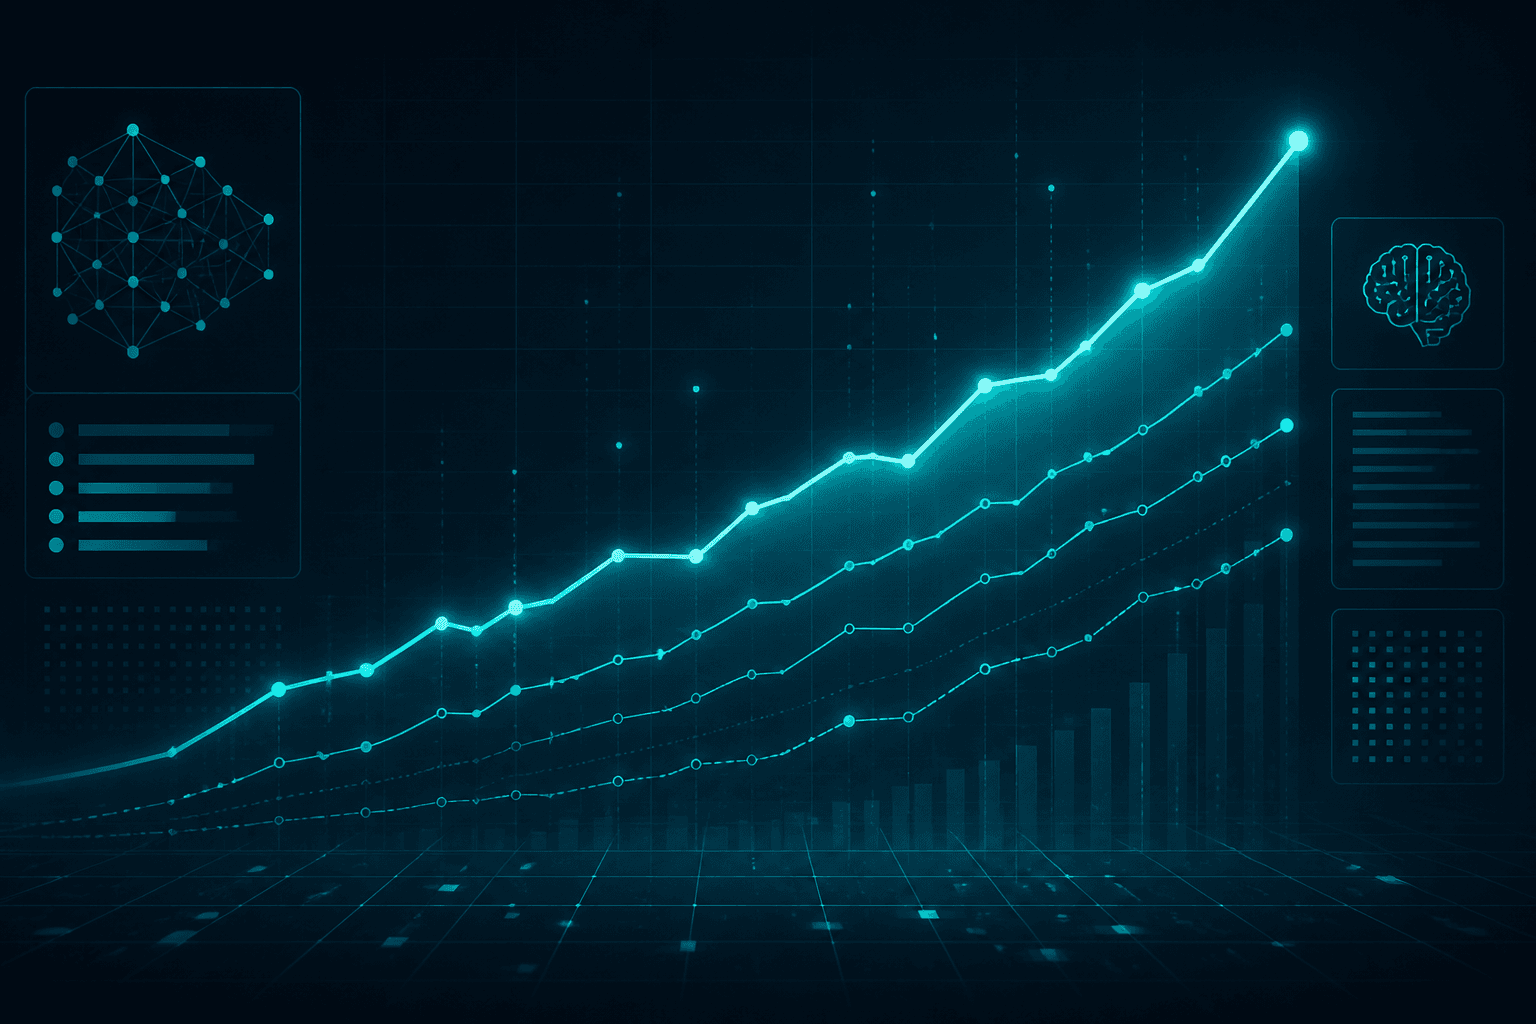
说明:上图为学习交流用途的概念示意,不代表厂商官方基准测试结果。
3. 与同门档位如何分工
同系列中,常见分工可以简化为:
| 档位 | 更适合 | 不太适合 |
|---|---|---|
| GPT-5.6 Sol | 复杂工程、系统攻坚、多代理协作 | 高频低成本闲聊 |
| GPT-5.5 | 全能均衡日常开发 | 极端长程 Agent 编排 |
| GPT-5.4 | 稳定生产与通用问答 | 前沿能力追新 |
什么时候该选 Sol?
建议优先考虑 Sol 的场景:
- 需要同时处理“设计 + 实现 + 验证”
- 任务跨多个代码库或服务边界
- 对交付完整性要求高于响应速度
- 你愿意用更高单价换更少返工
相反,若你主要做批量摘要、轻量客服、短文生成,国产高性价比模型或更快的 Flash/Instant 档位通常更划算。
使用建议与常见误区
- 不要把 Sol 当搜索引擎:先给约束、样本和成功标准,再让它执行。
- 拆阶段比一次扔需求更稳:调研 → 方案 → 实现 → 回归,分轮推进。
- 保留人工验收门槛:尤其是安全、权限、数据迁移相关改动。
- 对比时用你的真实任务:公开榜单只能参考,不能替代业务实测。
结论
GPT-5.6 Sol 代表的是“把复杂工作做完”的路线,而不是单纯刷分。对工程团队而言,它更像高级项目经理 + 资深架构师的组合助手;对个人创作者而言,未必总是最优解。
选型口诀可以记一句:任务越复杂、约束越多、返工越贵,就越值得上 Sol。
相关推荐
OpenAI 最新模型全解析:GPT-5.6 Sol/Terra/Luna 中文使用指南(2026 年 8 月更新)
2026 年 8 月更新:拆解 OpenAI GPT-5.6 系列 Sol、Terra、Luna 三档差异,给出中文使用方法、选型对照与可复制提示词,帮你按任务选对模型。
ChatGPT 2026 还能不能用?GPT-5.6 时代该怎么选对模型
解答 ChatGPT 在 2026 年是否过时:对比免费版、Plus 与 GPT-5.6 高阶能力,给出日常写作、编程与 Agent 场景的选型建议。
GPT Image 2.5 vs GPT Image 2:速度、光影、改图怎么选(2026)
对比 GPT Image 2.5 与 GPT Image 2 在出图速度、自然光影、参考保真、多轮定点改图上的差异,给出升级建议与国内体验入口,帮助你按任务选型。